lundi 12 août 2013

le compte est bon ... reste à savoir s'il fait de bons amis

Bon, le compte est bon... Je n'ai pas pu attendre l'année prochaine, cela faisait bien quelques années que le sujet me démangeait.

Avant tout, quelles sont les contraintes à gérer ?

- le temps : moins de 45 secondes pour trouver serait pas mal, et bien moins serait encore mieux
- les plaques : plus il y a de plaques dans les formules, plus c'est long à toruver
- les doublons : les doublons font des permutations inutiles, et donc du temps perdu, et le sujet est à la recherche du temps perdu ...
- la complexité des formules : plus il y a de parenthèses, plus c'est pénible à gérer, d'autant que certaines sont totalement superflues
- gérer les divisions pas entières

quelques problèmes résolus

il faut dire que pour résoudre la question, il aura fallu gérer un générateur de programmes, permettant de gérer les formules à analyser.

la génération des formules

Suivant le nombre de plaques, les formules générées varient en nombre et en qualité :

pour 2 plaques

la formule est de la forme a*b où "*" remplace un des 4 opérateurs standard
Il y a juste une formule générique : a*b

pour 3 plaques

la formule est de la forme a*b*c avec possibilité de rajouter des parenthèses
Il y a 3 formules génériques : a*b*c , (a*b)*c et a*(b*c)

à priori, le nombre de formules développées devrait être de 3 * 4^2 , soit 48.
Il faut cependant supprier les "FIC", les Formules Inutilement Coplexes comme (a+b)+c qui est la même que a+b+c, beaucoup plus simple.
Les formules développées sont au nombre de 20, en voici quelques unes :
try { gerer( a*b*c,"a*b*c",a,b,c,0,0,0 ) ; } catch( ArithmeticException e) {}// try { gerer( a+b+c,"a+b+c",a,b,c,0,0,0 ) ; } catch( ArithmeticException e) {}
( ... )
// try { gerer( (a*b)*c,"(a*b)*c",a,b,c,0,0,0 ) ; } catch( ArithmeticException e) {}
try { gerer( a/b/c,"a/b/c",a,b,c,0,0,0 ) ; } catch( ArithmeticException e) {}

Les lignes commençant par // sont des FIC.
Le nombre réel est d'enviro 50% du nombre théorique, ce qui permet déjà de diviser par deux le temps de calcul pour 3 plaques.

Nombre de formules par plaque

2 : 1
3 : 3
4 : 11
5 : 45
6 : 217 ( ah, oui, cela fait beaucoup, et cela ne tient pas comptes des quelques 6! permutations possibles )

Pour 6 plaques, donc 5 opérateurs, le nombre de formules théoriques est de 217 * 4^5 soit 222.208, donc 222.208 * 6! pour les permutations, soit 160 millions à quelque chose près.
L'optimisation a donc son importance.

Générer les formules

Là aussi le problème est de taille, pour 3 plaques, la formule générale est "?a?*?b?*?c?", où chque "?" peut représenter un "cretain nombre de parenthèses ouvrantes et fermante, le tout devant donner une formule arithmétiquement correcte, et elle aussi optimisée.
Typiquement, la formule a*(b*c)*d est valable, tout comme la formule a*((b*c))*d, sauf que là, il y a des parenthèses inutiles. Cette formule est à éliminer des formules utiles.

Son un PC dual core monothreadé tournant à 3 GHz, il aura fallu plus de 5 minutes à un programme java pour calculer TOUTES les formules plossibles pour 6 plaques. après optimisations expliquées ci-avant, ce temps passe à 90 secondes.

Concrétement

Concernant l'émission qui m'aura servi de référence pour "le mot le plus long" ( tirages consultables ici : http://fitness-greg.over-blog.com/article-pascal-a-encore-fait-une-bouchee-face-annick-119337317.html ), les tirages sont les suivants :

        new CompteEstBon( 5 , 9 , 25 , 2 , 7 , 5 , 782 ) ;
        new CompteEstBon( 7 , 1 , 2 , 9 , 100 , 25 , 844 ) ;
        new CompteEstBon( 4 , 5 , 1 , 9 , 8 , 6 , 607 ) ;
        new CompteEstBon( 10 , 3 , 10 , 4 , 6 , 3 , 881 ) ;
        new CompteEstBon( 2 , 3 , 5 , 4 , 7 , 9 , 205 ) ;
        new CompteEstBon( 1 , 4 , 25 , 5 , 10 , 7 , 785 ) ;

Le programme s'arrête au calcul impliquant le moins de plaques possibles.
Afin d'éviter les doublons qui n'auraient pas (encore) été filtrés, le programme affiche au maximum 4 calculs exacts. Le programme ne va donc pas (encore) chercher les calculs approchés.

tirage : 5    9    25    2    7    5    =    782

secondes pour 2 plaques : 0.003
secondes pour 3 plaques : 0.036
secondes pour 4 plaques : 0.09
782 = (5*5+9)*(25-2)    //    (a*b+c)*(d-e)    [5,5,9,25,2,0]
782 = (5*5-2)*(9+25)    //    (a*b-c)*(d+e)    [5,5,2,9,25,0]
782 = (5*5-2)*(25+9)    //    (a*b-c)*(d+e)    [5,5,2,25,9,0]
782 = (9+5*5)*(25-2)    //    (a+b*c)*(d-e)    [9,5,5,25,2,0]
secondes pour 5 plaques : 0.749
secondes pour 999 plaques : 0.889


Le programme trouve plusieurs résultats ( dont 50% de permutations ) en moins de 1 seconde pour 5 plaques.
Le résultat a été trouvé pour 5 plaques. Le résultat de l'émission est constitué de 6 plaques. Il faut dire que les tables de 23 et de 34 sont généralement assez peu utilisées.

tirage : 7    1    2    9    100    25    =    844

secondes pour 2 plaques : 0.001
secondes pour 3 plaques : 0.006
secondes pour 4 plaques : 0.139
844 = (7+2)*(100-9)+25    //    (a+b)*(c-d)+e    [7,2,100,9,25,0]
844 = (1-7+100)*9-2    //    (a-b+c)*d-e    [1,7,100,9,2,0]
844 = ((1-7+100)*9)-2    //    ((a-b+c)*d)-e    [1,7,100,9,2,0]
844 = (1+100-7)*9-2    //    (a+b-c)*d-e    [1,100,7,9,2,0]
secondes pour 5 plaques : 1.076
secondes pour 999 plaques : 1.222

Similaire au résultat trouvé. Les 2° et 4° solutions sont les mêmes aux permutations près.

tirage : 4    5    1    9    8    6    =    607

secondes pour 2 plaques : 0.0
secondes pour 3 plaques : 0.001
secondes pour 4 plaques : 0.052
secondes pour 5 plaques : 2.159
secondes pour 6 plaques : 50.656
secondes pour 999 plaques : 52.871

Cas typique de résultat exhaustif non trouvé ( 51 secondes pour les 6 plaques )
Vu les temps indiqués pour les 2, 3, 4 et 5 plaques, le temps total pour gérer les 6 plaques ( 51 secondes ) est hors cadre. Il doit encore manques des optimisations.
Dans l'émission, un résultat approché à 608 a été trouvé.

tirage : 10    3    10    4    6    3    =    881

secondes pour 2 plaques : 0.0
secondes pour 3 plaques : 0.001
secondes pour 4 plaques : 0.021
secondes pour 5 plaques : 0.618
secondes pour 6 plaques : 13.345
secondes pour 999 plaques : 13.986

Idem, et résultat approché trouvé à 880
Remarque : avec 2 plaques identiques, le temps de traitement des 6 plaques passe globalement de 50 secondes à 15 secondes.

tirage : 2    3    5    4    7    9    =    205

secondes pour 2 plaques : 0.0
secondes pour 3 plaques : 0.001
secondes pour 4 plaques : 0.045
205 = (2+3)*(5+4*9)    //    (a+b)*(c+d*e)    [2,3,5,4,9,0]
205 = (2+3)*(5*9-4)    //    (a+b)*(c*d-e)    [2,3,5,9,4,0]
205 = (2+3)*(5+9*4)    //    (a+b)*(c+d*e)    [2,3,5,9,4,0]
205 = (2+3+4*9)*5    //    (a+b+c*d)*e    [2,3,4,9,5,0]
secondes pour 5 plaques : 0.083
secondes pour 999 plaques : 0.13

Similaire à l'émission. La 4° solution proposée est bien plaisante.

tirage : 1    4    25    5    10    7    =    785

secondes pour 2 plaques : 0.0
secondes pour 3 plaques : 0.002
secondes pour 4 plaques : 0.106
785 = ((25-4)*7+10)*5    //    ((a-b)*c+d)*e    [25,4,7,10,5,0]
785 = (((25-4)*7)+10)*5    //    (((a-b)*c)+d)*e    [25,4,7,10,5,0]
785 = 25*(5*7-4)+10    //    a*(b*c-d)+e    [25,5,7,4,10,0]
785 = (25*(5*7-4))+10    //    (a*(b*c-d))+e    [25,5,7,4,10,0]
secondes pour 5 plaques : 1.23
secondes pour 999 plaques : 1.341

Similaire à l'émission

Conclusion

- des permutations difficiles à gérer
- des optimisations ( ? ) concernant les 6 plaques
- calculs approchés à prévoir
- gestion des plaques en double
- gestion "améliorée" des traitements des formules allant des calculs simples aux calculs complexes
- des chronos la plupart du temps très réduits
- le cas des 6 plaques encore problématique.

quelques références en ligne 

non exhaustif bien évidemment
http://www.langue-au-chat.fr/tricher-au-compte-est-bon/
http://fitness-greg.over-blog.com/

mercredi 7 août 2013

le mot le plus long : plus vite, plus long, plus fort !

Vive les vacances, vive les loisirs récréatifs !

ça y est, c'est le temps des vacances, le temps de la détente :D
Après quelques magazines achetés, que de jeux dedans, des mots avec des chiffres, des mots avec des lettres, sans compter "des chiffres et des lettres à la télé" ...

Allons bon, le sport cérébral, même en vacances, cela fatigue. déformation professionnelle peut-être ?
Pourquoi ne pas essayer d'améliorer tout ça ? De la recherche opérationnelle ? Faisons donc un programme permettant de se reposer un peu. Cela changera des programmes de résolution d'Othello, de Sudoku.

Quelques références de lettres

Ceux qui connaissent ce site fort utile aux cruciverbistes ( http://www.capeutservir.com/mots/ ) se diront qu'il est parfois utile de se concevoir des listes de lettres, voire des programmes de traitement de lettres. Tout un programme donc.

Mais où trouver des listes de mots ?
ce dictionnaire peut-être ? http://www.freelang.com/dictionnaire/dic-francais.php
Mais il contient des noms propres, et seulement 20.000 mots ( hors anagrammes ).

un dictionnaire du scrabble alors ? http://jmi67.free.fr/divers_docs/dico_scrabble.txt
300.000 mots ( hors anagrammes ), mais aux mot le plus long,  on n'a pas le droit aux verbes un peu trop conjugués, ni aux joker.

Bon, traitons cette petite liste afin d'en faire ressortir quelques faits intéressants ... le problème étant qu'un dictionnaire de scrabble ne sied pas forcément principalement à cause des conjugaisons.

voici donc quelques résultats au scrabble et au mot le plus long :

Au scrabble

Les mots les plus longs les plus anagrammés ?

15 lettres, 3 anagrammes chacun
aaeeegiinnrrsst : engraisseraient-reassigneraient-ressaigneraient
aaegiinnorsssss : engraissassions-reassignassions-ressaignassions
abdeeiillorssuz : bredouillassiez-debrouillassiez-debroussailliez
abdeeillnorsstu : bredouillassent-debrouillassent-debroussaillent
abeiillnnoorrtu : brouillonnerait-tourbillonnaire-tourbillonnerai
acdeeiilnnoorst : consolideraient-decloisonnerait-reconsolidaient
aceeeiinnoprrst : preconiseraient-receptionnaires-receptionnerais
aceeiilnoprrstt : interpolatrices-intertropicales-tropicaliserent

Les mots le plus anagrammés ?

7 lettres et 19 anagrammes pour aeinrst : aretins-arisent-entrais-inertas-inserat-ratines-rentais-resinat-retsina-riantes-satiner-sentira-seriant-serinat-taniser-tarsien-traines-transie-tsarine

Les mots faisant le plus de points au scrabble

ah, les joker valent 0, ne pas tenir compte des mots comme syzygie donc ( http://fr.wikipedia.org/wiki/Syzygie ) ni les cases spéciales.
en théorie 52 points avec psychophysiques, mais ce dictionnaire ne tient pas compte des lettres uniques ( ou bien améliorer les programme ).
Sinon 49 points avec les mots suivants : schizothymiques et deshypothequiez.

Pas mal d'idées en germe afin de reposer son cerveau donc.

Aux chiffres et aux lettres

l'objectif de cet article en fait.

Les mots les plus longs les plus anagrammés ?

aeeiprrsst, 11 anagrammes de 10 lettres ( mais avec conjugaisons :/ ) : periastres-persistera-presserait-presterais-pretirasse-rapetisser-repartisse-reprisates-respirates-retapisser-sparteries

Tirages du 31/07/2013

les tirages standards sortent les mots suivants et les maximaux :
QRANINOITA --> 7 avec antiroi et rainant
NERCFUAETE --> 9 avec centauree
CTOCESEISI --> 8 avec societes
NERAONLILU --> 8 avec lanoline
BRUDERSPED --> 7 avec perdues
BEBAENSONI --> 8 avec abonnies

Le programme sort quelques autres valeurs :
QRANINOITA --> 7 avec antiroi-rainant ( les mêmes )
NERCFUAETE --> 9 avec centauree( le même )
CTOCESEISI --> 8 avec cotisees-societes-siccites ( le même, et 2 autres )
NERAONLILU --> 8 avec neuronal-ouralien-lanoline ( le même, et 2 autres )
BRUDERSPED --> 8 avec perdures-reperdus ( reperdus est transitif et aurait donc dû être trouvé par la tablette numérique de l'émission ... ) , sinon avec 7 lettres :
presure-depures-derupes-eperdus-perdues-depurer-perdure-reperdu-beurres-puberes-superbe
BEBAENSONI --> 8 avec bobinees-oasienne-abonnies-abonnees ( le même, et 3 autres )

Tirages du 07/08/2013 et conclusion

De la même façon, le programme sort cet après-midi les mots les plus long, en presque 20 secondes sur un PC à 3 GHz. Dont environ 19 pour traiter les mots du dictionnaire. Le traitement est donc ultra-rapide, en force brute améliorée.
Comme quoi, une demi-journée de réflexion - pour concevoir le programme - permet de mieux aborder certains jeux de réflexion ...
Le compte est bon l'année prochaine :)

Pour aller plus loin

samedi 20 juillet 2013

quelques statistiques descriptives gliese / hipparcos

Bien sûr, bien sûr, contempler le ciel d'été est toujours d'un charme désuet, sinon d'un romantisme inégalé.

Lors d'un dernier billet, j'ai expliqué comment récupérer quelques données astronomiques en vue d'utilisations diverses : pilotage de télescope et statistiques diverses.

Protocole expérimental

Ces données sont issues des catalogues de l'université de Strasbourg, portant sur les données des travaux concernant Gliese et Hipparcos ( voire Tycho, voire le futur nouveau télescope avec mission de recensement de plus d'un milliard d'étoiles prévu pour 2013)

Ces données ( fichier tsv ) ont été portées dans une base de données locales - à défaut d'excel - afin de faciliter les traitements, notamment pour récupérer le type spectral ( i.e. G2 pour le soleil, étoile jaune ), la classe ( de hypergéante à naine blanche ), et fiabilisation de données. Ce genre de choses.

La bibliothèque jfreechart a été utilisée, en reprenant quelques graphiques potentiellement intéressant, personnalisés pour afficher les couleurs selon les types spectraux.

Voici descriptivement ou contemplativement les résultats obtenus.

Stellarium

Stellarium latitude/longitude pour magnitudes visuelles inférieures à 6. Plus la magnitude visuelle est faible plus la couleur est foncée.

Représentation des types spectraux

Les étoiles jaune et orange sont les plus représentées. Pour information, les naines brunes sont les étoiles les plus représentées dans l'univers, mais assez difficilement détectables à longue distance.

Répartition RA / DE

Schéma présentant la répartition de volumétrie des étoiles selon les longitudes / latitudes.
Peut-on en déduire que les missions ont privilégié l'hémisphère nord ?

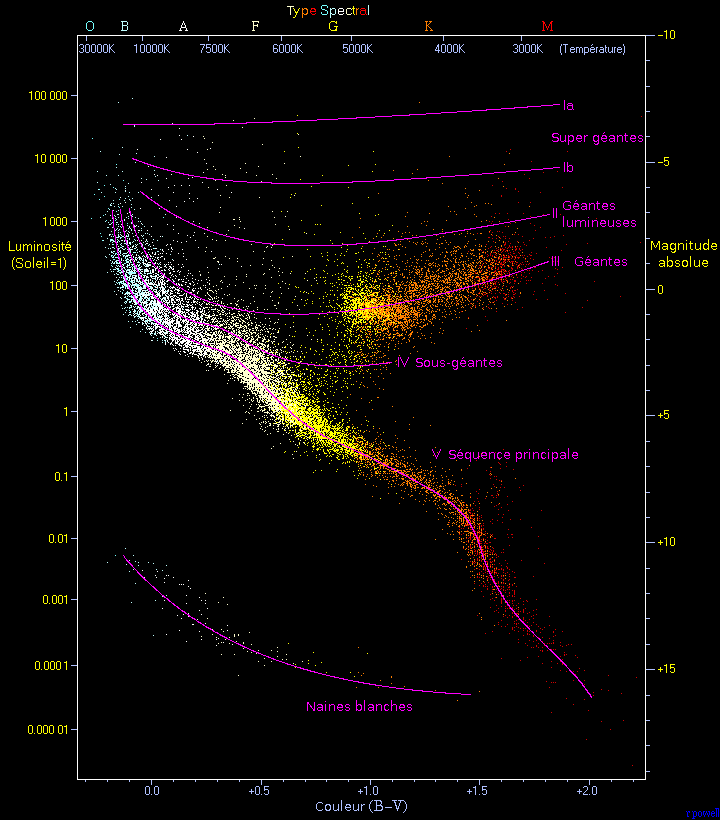
Diagramme HR

Schémas présentant les diagrammes HR ( Hertzsprung-Russell  ) sur Gliese et Hipparcos. Plus fiable sur Gliese ...
En bas à gauche, les naines blanches.
A droite des naines blanches, ( en bleu ) les étoiles naines carbonées.
Les types spectraux Harvard usuels sont les types colorés dans ces diagrammes ( http://fr.wikipedia.org/wiki/Type_spectral )

Pareto magnitudes

Schéma présentant en diagramme cumulatif les différentes magnitudes visuelles déterminées par les missions spatiales
Visiblement les informations fournies par Hipparcos sont ne sont pas moins bonnes comme pourrait le suggérer ce graphe, il s'agit simplement d'un volume de données nettement plus important ( 4000 contre 87.000 )

Erreurs sur données

fort utilement, les données brutes sont parfois associées à une colonne "erreur sur la donnée".

Parallaxe

Voici ce que cela donne pour la parallaxe ( en milliseconde d'arc ), et pour l'indice colorimétrique B-V notamment utilisé par les diagrammes HR L'ordonnée E_xxx correspondant à la colonne d'erreur.

Ecart sur l'indice colorimétrique B-V

Typiquement dans la littérature, les valeurs pertinentes de B-V correspondent à une marge d'erreur inférieure à 0.02.

Spectre différentiel

Les indices colorimétriques B-V, V-I et U-B permettent de déterminer des caractéristiques cosmologiques séparant la terre de l'étoile considérée, comme la présence de nuages de gaz ( hydrogène ). Néanmoins, il existe souvent une certaine corrélation en rapport à ces indices.

 Corrélation selon les magnitudes visuelles

Pertinence des types spectraux

Typiquement, une couleur correspond à une position bien précise dans un diagramme HR ( indice B-V, couleur et températures sont entre autres caractéristiques liées.
Dans les données récupérées, ce n'est pas trivial au vu des écarts.

Anomalie de présence des sous-types spectraux

Un type spectral ( G pour les étoiles jaunes ) se décline en 10 sous-types spectraux de G0 ( jaune blanchâtre ) à G9 ( jaune orangé ).
En affichant la population des sous-types, l'on s'aperçoit que certains sous-types sont fortement sous-représentés.
Forte représentation dans les segments : 0 et 5
Faible représentation dans les segments : 6 et 9
Une explication pour les sous-types 9 pourrait être un report sur le sous-type 0 du type voisin.
Pas d'explication pour le type 6, probablement phagocyté par le sous-type 5 voisin.
D'une manière générale, les types 6-9 sont moins représentés que les sous-types 0-5.
La représentation des types est la suivante

quelques liens

http://fr.wikipedia.org/wiki/Soleil
http://vizier.u-strasbg.fr/viz-bin/VizieR
http://fr.wikipedia.org/wiki/Type_spectral
http://fr.wikipedia.org/wiki/Absorption_interstellaire
http://fr.wikipedia.org/wiki/Classe_de_luminosit%C3%A9
http://fr.wikipedia.org/wiki/Magnitude_apparente

jeudi 30 mai 2013

Les rois de la Gliese

Introduction

Si vous regardez le ciel la nuit, les fois où le temps le permet, vous pouvez voir dans le ciel les étoiles proches de nous, voire d'autres plus loin et très lumineuses.

Récupération des données

Si vous avez un télescope, voire si vous êtes curieux, vous pouvez trouver des cartes du ciel pour observer planètes et étoiles. Cela peut même se faire depuis quelque recherche depuis Wikipedia. Le Catalogue Gliese recense les étoiles proches.
http://fr.wikipedia.org/wiki/Catalogue_Gliese
L'université de Strasbourg met en ligne quelques bases de données permettant de récupérer étoiles et objets extra-galactiques, dont le catalogue Gliese et ses extensions.
http://vizier.u-strasbg.fr/cgi-bin/VizieR-2?-source=V/32A
 
 aperçu de la restitution du requetage

 
 Choisir le format de restitution des données ( html ou fichier )
 
Extrait des données récupérées

Présentation des données

L'objectif à partir de ces données et de présenter ces étoiles selon certains critères visuels :

 Représentation des étoiles selon les types spectraux
N.B. les couleurs ne correspondent pas aux couleurs réelles des étoiles.
 
Représentation des étoiles selon les classes de luminosité
  • une représentation 3D des objets.

Pour l'illustration, l'image ci-après représente quelques constellations ( orion, triangle, cassiopée, cancer ) sur un planetarium épuré.

Quelques informations complémentaires

  • Si ces données ont été tirées des catalogues Vizier de l'université de Strasbourg, vu les quelques essais effectués, le catalogue Gliese est quand même celui qui fournit le diagramme HR le plus conforme à ce que l'on voit dans les manuels d'astronomie.
  • De nombreuses données sont récupérables, typiquement la distance, ceci permettrait de représenter l'univers proche dans un vrai système 3D et non au format mappemonde. C'est déjà traité, mais la taille et la couleur des étoiles n'ont pas encore été prises en compte.
  • des données incomplètes voire fortement atypiques ont été omises.

mardi 2 avril 2013

Comparatifs graphique de processeurs sur sockets Intel

Objectif

Représenter différemment les informations présentées sur ce site : http://www.cpubenchmark.net/socketType.html#id1 La page suivante plus précisément :

Moyens

La bibliothèque JFreeChart ( java donc ) permettant de représenter des graphes et autres outils de restitution graphiques. http://www.jfree.org/jfreechart/ et en démo ici : http://www.jfree.org/jfreechart/samples.html

Procédure

  • lecture de l'URL
  • traitement de la page, récupération des données ( si pas de prix en dollar, le prix est nul )
  • constitution de datasets en fonction des gammes des processeurs ( i.e. "Intel Core I3-" )
  • affichage de 3 images selon les types d'informations à prendre deux à deux parmi fréquence du processeur, prix et performance brute du processeur.

Résultats

Résultats prix /fréquence

Commentaires

  • les gammes de processeurs s'étagent assez bien selon les gammes de prix
  • quelques bizarreries tarifaires dans les gammes moyennes ( probablement dues au renouvellement partiel des gammes dans le temps )

Résultats performance / fréquence

Commentaires

  • corrélation assez forte entre fréquence et performance par gamme de produit
  • quelques processeurs avec fort potentiel ( vers fréquence à 2.5 gHz et performnce à 9000 )

Résultats prix / performance

Commentaires

  • corrélation assez forte entre tarif et performance pour toutes les gammes de produit
  • certains Xeon à très mauvais rapport qualité / prix
  • meilleure performances des nouvelles générations par gamme ( comparaison des séries 3xxx par rapport aux 2xxx )

Conclusions 

Informatiques

  • le site cpubenchmark.net présente des informations brutes ( en tableau ), mais mériterait avantageusement à les présenter sous forme de graphes
  • un bon graphe ( voire plusieurs ) complètent bien certains tableaux, et c'est toujours mieux qu'un long discours ...
  • les commentaires à faire sont bien ceux que l'on retrouve dans les magazines informatiques spécialisés, tout se retrouve.
  • pouvez-vous maintenant choisir un processeur sur ses performances brutes ? Préférez-vous les informations tabulaires ?

JFreeChat

  • facilité avec JFreeChart à partir d'un modèle de données pour générer des graphes à partir de données "tabulaires" issues du web ( une soirée pour analyser les données, coder, présenter et saisir ce billet )
  • généralisation du procédé aisé pour tous les processeurs du site, à condition d'identifier les gammes ( codé en dur ) et générations afin de déterminer les bons datasets
  • la taille des bulles ( il s'agit de bubblegraphes ) dépend de l'étendue de l'axe Y en fait ( taille ~ 2 pour 100 )
  • les données sont extraites en temps réel

Post conclusion ( si, cela existe, au mins dans ce blog )

En fait, l'affichage avec des "bubbleChart" n'est pas terrible, voici le rendu d'un "scatterPlot", et c'est autrement plus lisible ainsi présenté :

Et voici le bout de code qui crée ou complète la série en coordonnées doubles :
                XYDataItem item = new XYDataItem(x, y) ;
                XYSeries uneSerie ;
                try
                {
                    uneSerie = dataset.getSeries(serie) ;
                    dataset.removeSeries(uneSerie) ;
                }
                catch ( UnknownKeyException e )
                {
                    uneSerie = new XYSeries(serie) ;                                       
                }
                uneSerie.add(item) ;               
                dataset.addSeries(uneSerie) ;               


jeudi 31 janvier 2013

java 3D en mouvement

Après la découverte de Java 3D pour mieux afficher des puits de potentiel en maillage fil de fer
http://sylvainspeh.blogspot.fr/2012/10/application-numerique-concernant-les.html
ce qui peut amener à cette représentation pilotable à la souris dont les pentes sont gérées en dégradé de couleurs afin d'améliorer le rendu :

une nouvelle application de java 3D : un petit jeu de déplacement dans un labyrinthe, avec la carte des mouvements et l'orientation du "personnage".


Là, pas encore question d'égaler les prouesses d'un certain plombier ;) ou d'une célèbre aventurière , il s'agit de simplement se déplacer dans un univers bordé par des murs, déplacer la caméra représentant l'observateur ce genre de choses.
Il y a encore du travail à faire pour ressembler à Wolfenstein 3D ( le premier du genre, cf. ci dessous ),

 mais avec relativement peu de code, il y a moyen de faire des choses intéressantes afin d'utiliser quelques possibilités offertes par cette api.
La gestion des déplacements se fait au clavier. Je suis preneur d'informations concernant la gestion des joystick en java.

quelques liens :
http://rvirtual.free.fr/programmation/java3d/intro.html
http://www.eteks.com/coursjava/java3D.html

dimanche 28 octobre 2012

application numérique concernant les points de Lagrange

Connaissez-vous les points de Lagrange ?

Ces points au nombre de 5 sont des points spatiaux permettant à des objets célestes "ponctuels" d'être en orbite "stable" par rapport à 2 corps massifs de référence. Les plus connus étant les astéroïdes troyens croisant au niveau de l'orbite de Jupiter.

http://fr.wikipedia.org/wiki/Point_de_Lagrange et http://fr.wikipedia.org/wiki/Ast%C3%A9ro%C3%AFde_troyen

La méthode de calcul retenue http://ressources.univ-lemans.fr/AccesLibre/UM/Pedago/physique/02/divers/lagrange.html et http://ressources.univ-lemans.fr/AccesLibre/UM/Pedago/physique/02/divers/lagrange.pdf permet d'afficher dans une page web les positions desdits points pour des rapports de masse de 2 à 25.

Généralisons le problème, et faisons afficher sur une même image générée par un programme java :
  • en jaune, les 2 points de référence ( le Soleil et la Terre par exemple, dont le rapport de masse vaut 3.10^5 )
  • en magenta, les 5 points de Lagrange
  • en niveau de gris, les niveaux d'énergie potentielle en unités arbitraires ( plus c'est foncé, plus c'est négatif, et moins c'est stable )
  • la plus forte masse se situe au centre de l'image, la moins forte à droite.

Ce qui donne, pour des rapport de masses de 3*10^5, 100,  25 et 1 les représentations suivantes :

Pour 3*10^5

Un point de Lagrange est confondu avec la Terre sur l'image


Pour 100


Pour 50


Pour 25


Pour 1

la représentation est bien symétrique


améliorations possibles

Il ne reste plus qu'à trouver un moyen de représenter ces informations en 3D afin de bien voir que les 3 points alignés avec les 2 astres sont bien des points instables, contrairement aux 2 points situés de part et d'autre de l'axe des X.

Une petite application en java3D a été conçu a cet effet, qui reproduit le modèle en 3D. Voici une copie d'écran représentant les puits de potentiel en 3 dimensions pour un rapport de masse de 25 représenté ci-avant en 2D. Les zones stables n'ont pas encore été représentées..


Exemples d'autres représentations possibles :
http://sciences-physiques.ac-dijon.fr/astronomie/lexique/lexique_astro/l/images/puits_potentiel.gif
et pour le système Terre-Lune :
http://i.space.com/images/i/15157/i02/earth-moon-lagrange-points.jpg?1328752769